Data & Model Services
让数据进入可训练、可评测、可交付的状态
数据与模型服务连接业务数据与人工智能应用。瑞铭安普根据任务目标和数据条件,组织数据准备、多模态标注、质量治理、模型训练、评测调优与版本交付;具体范围、指标和部署方式通过代表性样本及项目约定确认。
- 01数据采集
- 02清洗治理
- 03数据标注
- 04质量审核
- 05模型训练
- 06评测调优
数据准备
围绕业务目标梳理来源、格式、授权、清洗规则和数据集版本,为后续加工建立边界。
多模态标注
按任务需要组织图像、视频、文本、语音等数据标注,并通过试标校准减少规则歧义。
质量治理
将抽样复核、一致性评估、争议仲裁、错误回流和版本追溯纳入生产过程。
模型工程
结合数据条件开展训练、评测与调优,以代表性样本和约定指标验证适用范围。
Insights & Practice
数据服务洞察与实践
围绕数据质量、标注规范、模型训练与项目交付,持续沉淀可验证的方法和实践。
-
-
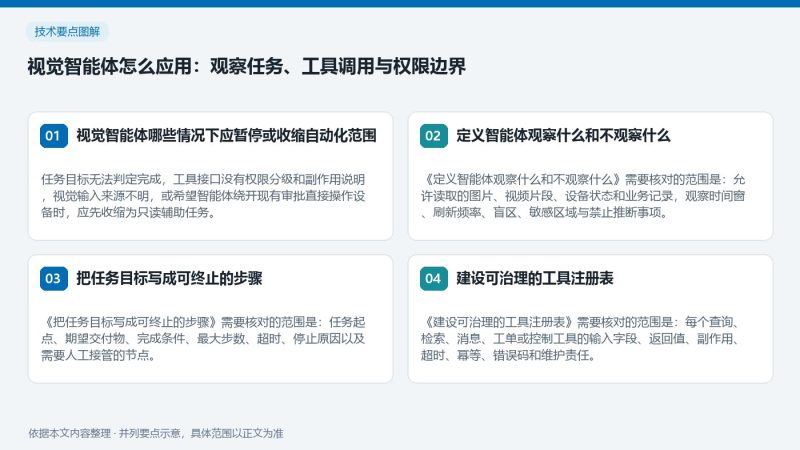
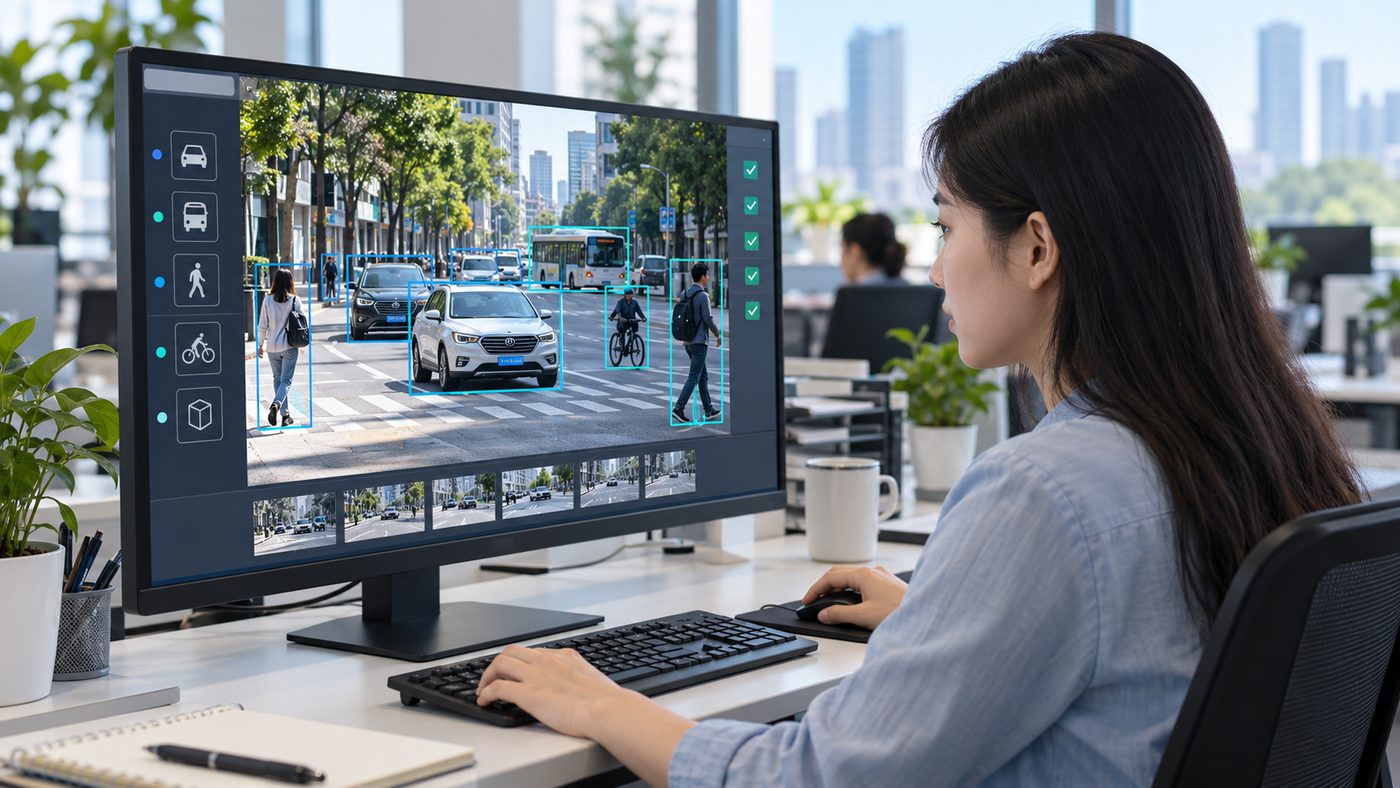
人员轨迹分析系统怎么建设:跨点关联、时空校验与使用边界
人员轨迹分析系统需要在明确授权和最小必要范围内,将不同点位的时间、空间与候选特征进行关联。结果只是概率性或规则性线索,必须经过人工与其他证据校验。
阅读全文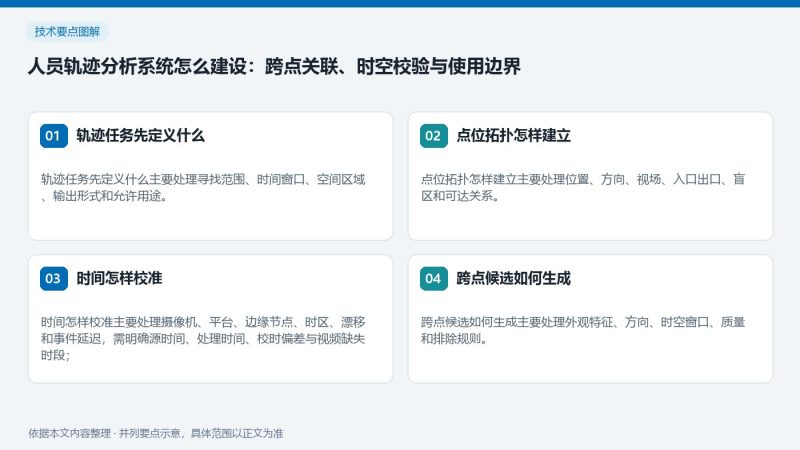
-
-
-
数据血缘和元数据管理:让企业数据"来龙去脉"看得见
报表上一个数字不对,技术团队要花半天翻脚本找原因;改一个字段,不知道会影响哪些下游报表;业务人员看到一个表名,不知道是什么意思、能不能用。这些问题的根源,都是缺少元数据管理和数据血缘。本文说明这两个概念分别解决什么问题、血缘有哪些采集方式及其覆盖边界、企业落地时先做什么,以及怎么判断做得成不成功。
阅读全文
-
数据清洗与数据审核:AI训练数据为什么要先"打扫干净"
模型训练效果不好,很多时候不是模型不够大,而是训练数据质量差。数据从各个渠道收集上来,有重复、有错误、有标注不一致、有敏感内容,直接喂给模型会导致输出混乱。数据清洗和数据审核就是在数据进入训练之前,把脏数据整理规范、把不合格样本筛出来。本文侧重"训练前的整理与把关"环节,说明清洗与审核的分工、处理流程、质量标准与常见误区。
阅读全文